Почему облачный STT на бумаге 250 мс, а в реальном звонке перевод и подсказки срываются.
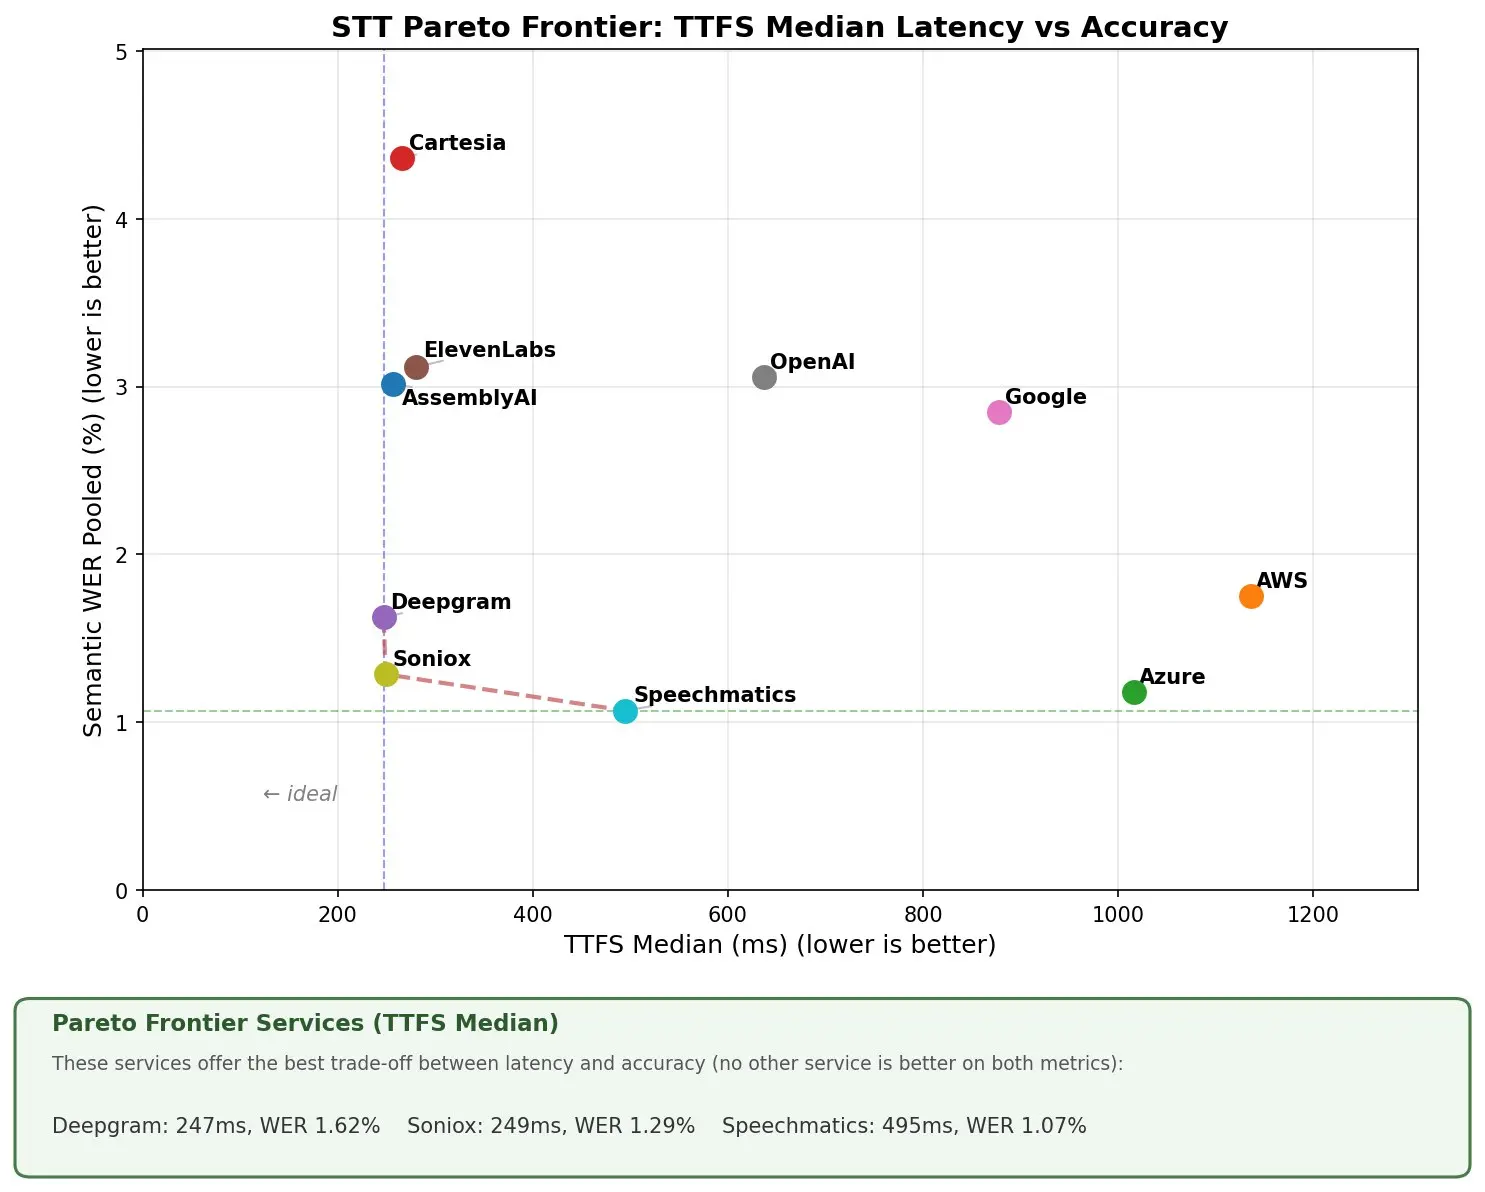
Бенчмарки Deepgram, Soniox дают TTFS median 247–249 мс, WER 1.3%. Но это чистый микрофон в лаборатории. На Windows аудио проходит через Audiodg.dll, DPC/ISR добавляют 100–400 мкс на буфер, сеть + очередь облака — ещё 150–600 мс. Partial приходит, когда ты уже начал отвечать. Смешанный поток делает хуже: STT видит оба голоса в одной каше.
Talkaside на WASAPI открывает два независимых клиента. Capture на микрофоне (eCapture), loopback на render endpoint с AUDCLNT_STREAMFLAGS_LOOPBACK. Каждый ресемплится отдельно в 16 кГц моно, VAD Silero режет чанки 200–500 мс. Локальный Whisper или Parakeet дают first token за 250–600 мс на CPU/GPU без сети. Авто-фейловер мерит latency. Если текущий >300 мс на partial — переключает на локальный без разрыва.
История, записи, транскрипт с таймстемпами остаются на машине. Companion mode даёт короткие подсказки. После — поиск, экспорт, AI-сводка.