Локальные базы уязвимостей — как собрать БДУ, NVD, CPE и OSV
Почему одной базы мало: (продолжение общения https://set.ki/post/9txPQnM) Когда я начинал, казалось: есть NVD — и хватит. На практике каждая база отвечает на свой вопрос, и без них композиционный анализ получается однобоким. БДУ ФСТЭК — основная для российского заказчика. Даёт русские описания, статусы устранения и эксплуатации, номера BDU. Если в отчёте только CVE, заказчик не может сопоставить находку с БДУ — а именно по ней у него строится регламент.
NVD — CVE и CVSS. Даёт метрики критичности, которых в БДУ может не быть, и покрытие шире по международным продуктам.
CPE — словарь NIST для сопоставления продуктов и версий. Без него «openssl 1.1.1» и «OpenSSL:1.1.1» — разные строки, а с ним — один компонент.
OSV — база Google по экосистемам (npm, PyPI, Go и т.д.). Для современных зависимостей она точнее NVD по диапазонам версий.
JVN — японская база. Даёт описания и находки, которых нет в NVD, особенно по встраиваемому ПО и японским вендорам.
GHSA — база GitHub. На первый взгляд может показаться, что она дублирует NVD и OSV, но это не так. GHSA — это не просто ещё один список CVE, а отфильтрованный и обогащённый слой поверх них, заточенный под конкретные экосистемы пакетов . Для современных проектов (npm, PyPI, Go, Maven, NuGet, Rust) она часто даёт более точные диапазоны уязвимых версий и ссылки на исправления, чем сырой NVD. Но хранить их отдельно удобно: одна и та же уязвимость может иметь разные оценки в разных источниках.
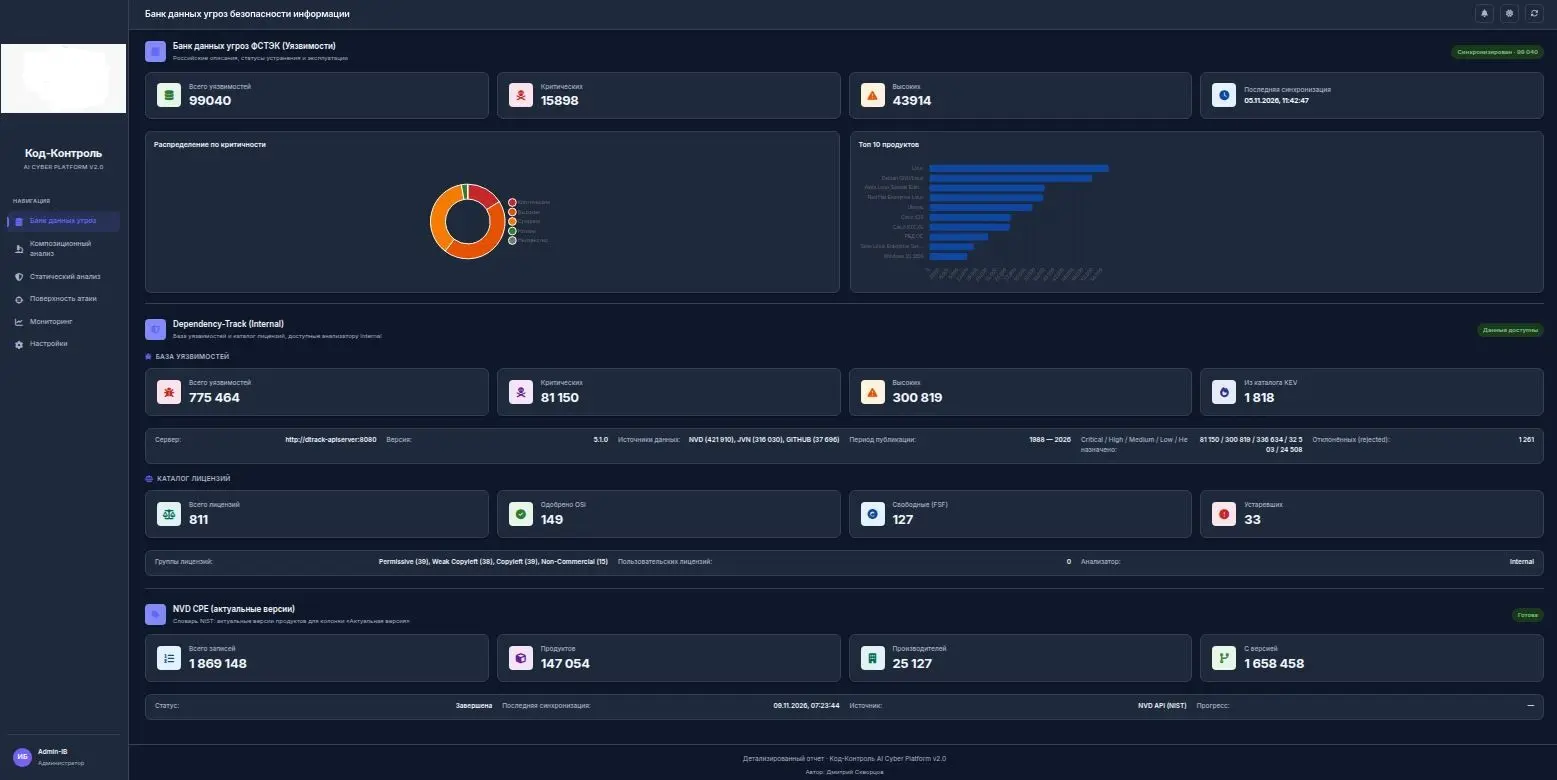
На скриншоте — статус источников: что синхронизировано, когда, сколько записей. Дальше разберу, как это устроено. Как хранить локально Полная перезаливка каждой базы — это часы и гигабайты. Поэтому — инкрементальные обновления: · каждая база хранится с меткой последней синхронизации; · при обновлении запрашиваются только записи, изменённые с этой метки; · старые записи не удаляются, а помечаются как устаревшие — чтобы отчёт по прошлому анализу оставался воспроизводимым. Для CPE это особенно важно: словарь большой, но меняется точечно. Для OSV — наоборот, обновления частые и мелкие, поэтому инкремент даёт наибольший выигрыш. Для GHSA инкремент критичен по другой причине: GitHub обновляет базу неравномерно, и если тянуть её целиком каждый раз, можно часами ждать, пока прокачаются тысячи записей по npm и Maven, которые вам сегодня не нужны.
Расхождения не скрываются. Если CVE из БДУ относится к другому продукту (так бывает — сопоставление по номеру не всегда точное), в отчёте это помечается отдельно. Лучше показать «CVE относится к другому продукту», чем выдать ложную находку за чистую монету.
Что дальше
В следующем посте — проблемы композиционного анализа.
Чем можно дополнить?