Шалость удалась (часть 7)
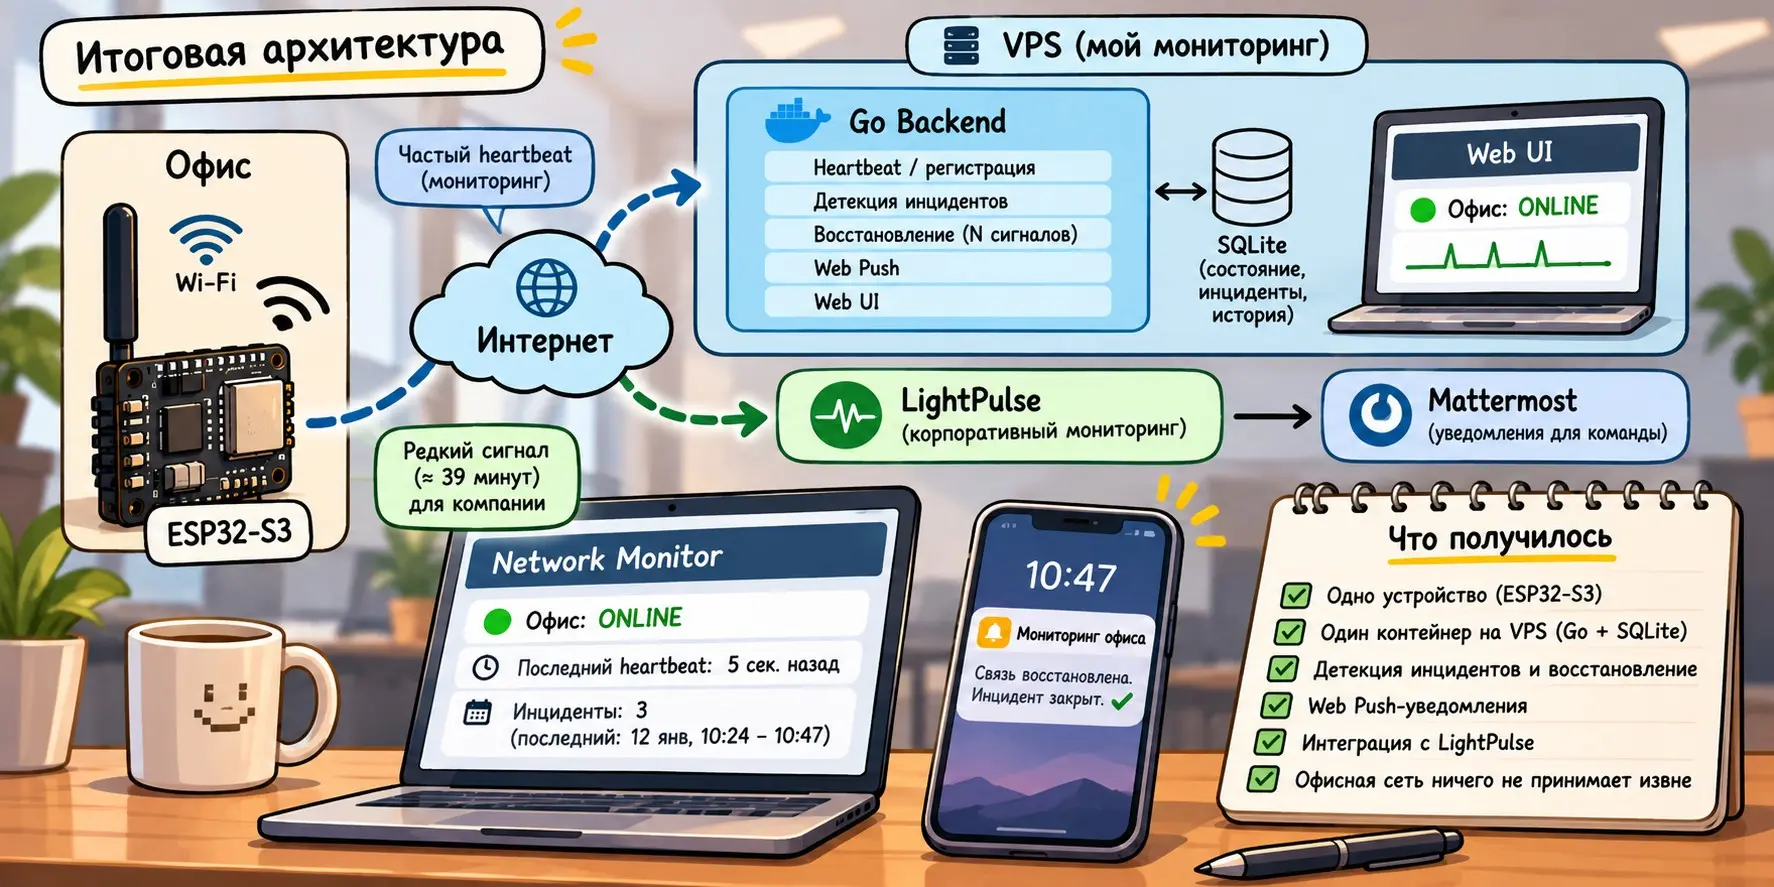
Что в итоге получилось После всех экспериментов, отказов от первоначальных решений и новых требований архитектура оказалась даже проще, чем на некоторых промежуточных этапах. В офисе осталась одна ESP32-S3. Без Ethernet-модуля, белого IP и открытых портов. Устройство подключается к обычному Wi-Fi и самостоятельно обращается к внешним сервисам.
На VPS работает Go backend: принимает heartbeat, хранит состояние в SQLite, обнаруживает инциденты, отправляет Web Push и раздаёт Web UI. Отдельно существует LightPulse, куда ESP32 посылает более редкий корпоративный сигнал. И главное — офисная сеть ничего не принимает извне. Не нужно настраивать удалённый доступ к роутеру или пробрасывать порты.
Что происходит при обычной работе После включения ESP32 подключается к офисному Wi-Fi и периодически отправляет heartbeat на VPS. Каждый полученный сигнал означает, что в этот момент устройство работало, смогло подключиться к Wi-Fi, пройти через роутер и интернет и достучаться до backend. Это не проверка скорости соединения и не полноценная диагностика сети. Но мне и не требовалось измерять мегабиты. Мне нужен был ответ на простой вопрос: офис сейчас способен выйти в интернет?
Когда связь исчезает Если heartbeat перестаёт приходить, backend не объявляет аварию сразу. Он ждёт, пока время с последнего сигнала превысит установленный порог. Затем переводит устройство в OFFLINE, открывает инцидент и инициирует уведомление. При этом система не знает причину молчания. Мог отключиться Wi-Fi, роутер или интернет у провайдера. Могло пропасть электричество. А могла перестать работать сама ESP32 или оказаться недоступным VPS. Для backend всё это выглядит одинаково: устройство давно не сообщало о себе. И для моей задачи этого достаточно. Если офисное устройство долго не может связаться с внешним сервером, ехать в офис в расчёте на стабильный интернет уже рискованно.
Как фиксируется восстановление Когда heartbeat снова появляется, первый успешный запрос ещё не закрывает инцидент. Backend ждёт три успешных сигнала подряд и только затем возвращает устройство в ONLINE. Так кратковременное восстановление не заставляет мониторинг постоянно переключаться между двумя состояниями. А в истории остаются начало и конец каждого инцидента. Один probe — два независимых сигнала Кроме частого heartbeat на мой backend, ESP32 примерно раз в 39 минут обращается к LightPulse.
Личной системе мониторинга важно быстро обнаруживать потерю связи. Корпоративному сервису достаточно редкого подтверждения доступности офиса. Физически устройство одно, но оно обслуживает два сценария с разными интервалами и назначением.
Simulator никуда не исчез Когда приехала настоящая ESP32, симулятор не отправился в корзину. Наоборот, он стал удобным инструментом разработки. Я мог локально зарегистрировать виртуальное устройство, отправлять heartbeat, остановить симуляцию, дождаться OFFLINE, затем возобновить сигналы и проверить восстановление. И всё это без поездки в офис и перепрошивки платы после каждого изменения backend.
Забавно, что временная заглушка, написанная в ожидании железа, превратилась в полноценный инструмент тестирования.
А что система на самом деле мониторит? Здесь стоит сделать важную оговорку. ESP32 не измеряет SLA провайдера, не запускает Speedtest, не анализирует packet loss и не строит traceroute. Она проверяет более узкую вещь: может ли устройство, физически находящееся в офисе, выйти через офисную сеть к известному внешнему сервису. Поэтому отсутствие heartbeat не означает автоматически, что виноват провайдер. Проблема может быть на любом участке пути — от питания ESP32 до VPS. Но изначально я и не собирался строить лабораторию сетевой диагностики. Я хотел знать: если сейчас приеду в офис и открою ноутбук, есть ли основания ожидать, что интернет там работает?
И с этим маленькая ESP32 вполне справляется.
Продолжение следует…
#ESP32 #IoT #GoLang #Backend #SQLite #Мониторинг #PetProject #WiFi #Разработка