«Почему мы ушли от синхронного REST в AI-агентах к Event-Driven» ⚡🧠
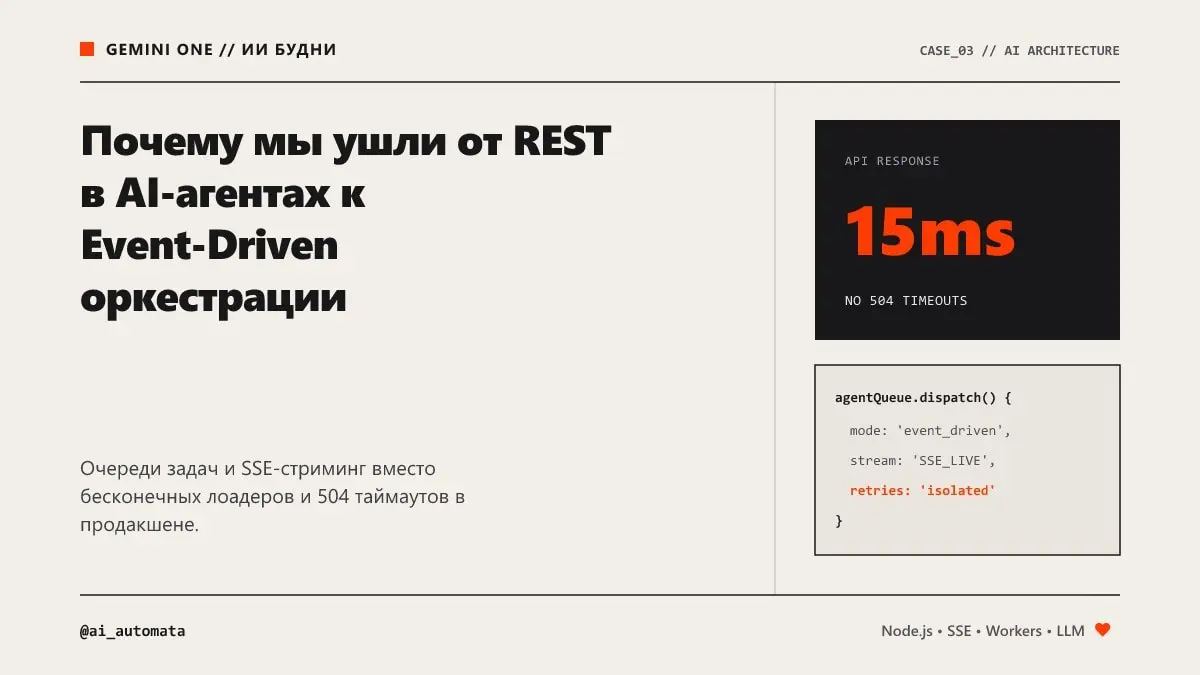
Когда интегрируешь LLM в продакшн, первая ошибка — делать обычный POST /generate и вешать бесконечный спиннер. На цепочках из 3–4 агентов HTTP-соединение рвётся по таймауту уже на 60-й секунде.
Мы перевели наших агентов на событийную модель (Event-Driven) и получили мгновенный отклик UI:
⚙️ Как устроена архитектура: • Очередь задач: клиент не ждёт ответа от модели. Бэкенд возвращает ID задачи за 15 мс и отдаёт её воркерам. • Стриминг прогресса (SSE): вместо пустого экрана пользователь в реальном времени видит этапы («Анализ ➔ Генерация ➔ Валидация»). • Изолированные ретраи: если шаг упал из-за лимитов API, перезапускается только он, а не весь запрос.
💡 Инсайт: Не привязывайте цикл AI-агента к одному HTTP-запросу. Очередь + стриминг статусов спасают от 504 Timeout и оттока юзеров.
👇 А как вы разруливаете долгие ответы нейросетей на бэкенде?