Почему перевод в твоём собственном голосе на живом звонке всё равно звучит как чужой робот.
Обычные speech-to-speech берут микс. Speaker encoder путает стороны, embedding плывёт. Облачные клоны добавляют 1.5–3 с задержки — к моменту ответа фраза уже ушла.
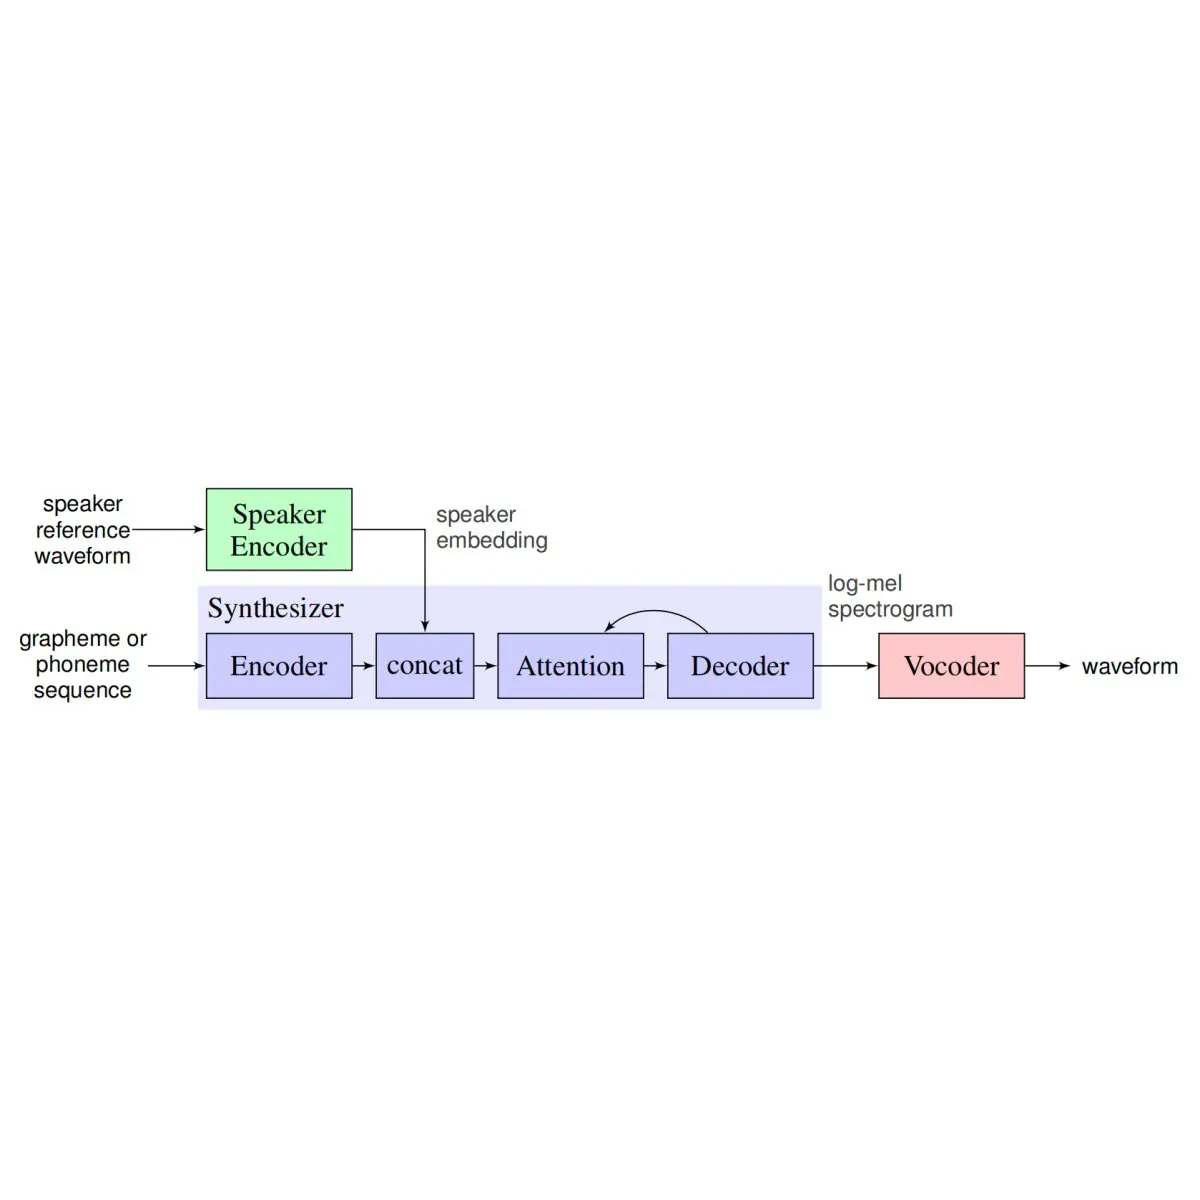
Talkaside открывает dual-stream WASAPI: микрофон (outgoing, capture) и loopback системного звука (incoming, AUDCLNT_STREAMFLAGS_LOOPBACK, shared). Чистый outgoing идёт в локальный speaker encoder (по типу SV2TTS: 256-d embedding из 3–5 секунд речи). Embedding + переведённый текст уходят в synthesizer и vocoder. На RTX first-chunk 95–250 мс, RTF 0.1–0.3. Локальный Whisper/Parakeet + Hy-MT2 держат перевод на машине, 27 языков.
В practice mode проговаривает разбор твоим голосом. Companion подмешивает короткие формулировки. После звонка полный транскрипт с таймстемпами, поиск, экспорт и AI-сводка лежат в %LOCALAPPDATA%Talkaside. Ты выбираешь, какие модели трогают аудио.
Стороны разделены, клон стабилен, история остаётся у тебя.