Почему перевод в чужом робо-голосе убивает доверие на живом звонке, даже когда слова правильные.
Обычный TTS выдаёт синтетический голос. Собеседник слышит чужую интонацию, теряет связь. На переговорах или практике языка поток ломается.
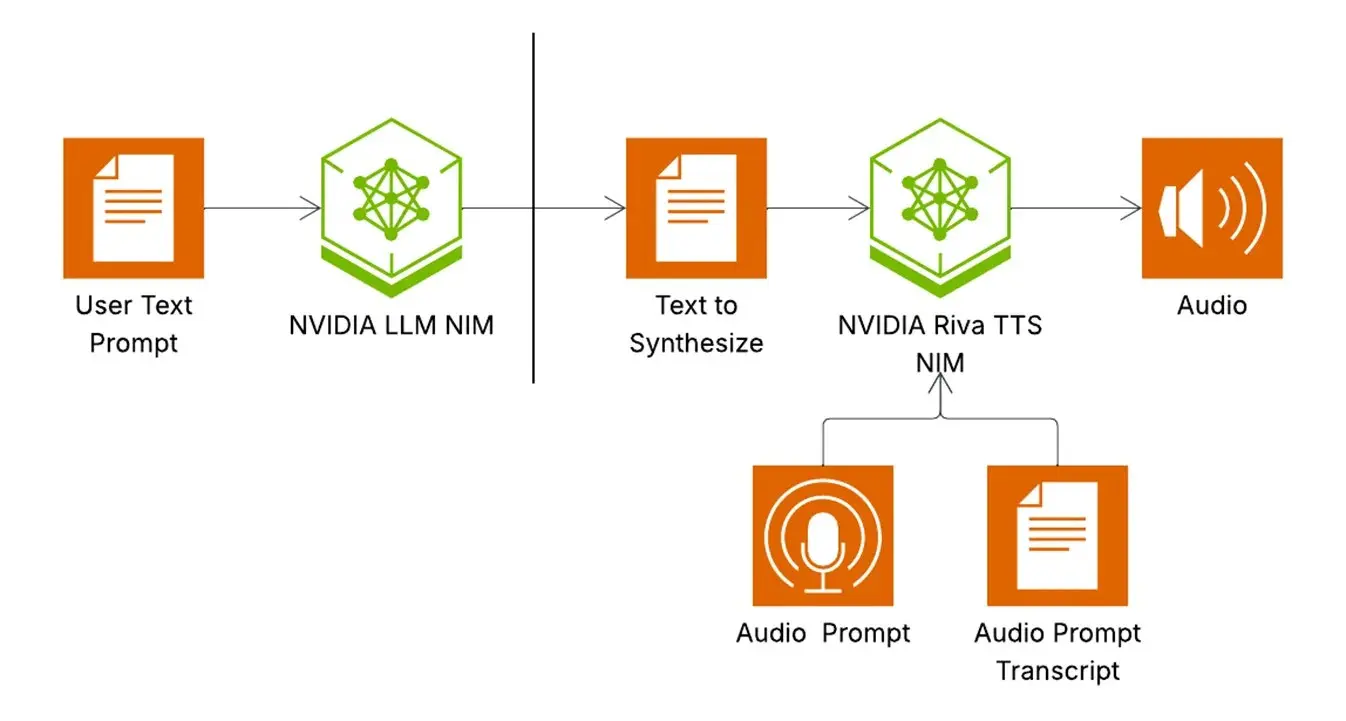
Voice cloning иначе. Speaker encoder берёт сэмпл твоего голоса (5–20 с), вытаскивает embedding (pitch, timbre, prosody). Acoustic model или codec LM кондиционирует на него. Vocoder собирает waveform. Zero-shot без долгого fine-tune.
Talkaside на чистом outgoing треке. Dual-stream WASAPI (capture + loopback) даёт раздельные PCM. Твой голос в локальный или выбранный TTS с клоном. Перевод (27 языков) звучит тобой. Incoming чистый для анализа.
Streaming TTS: first chunk 150–300 мс. Failover если тормозит. История, записи, транскрипт с таймстемпами на диске. Ты выбираешь провайдеров.
После звонка полный разбор. Голос твой — доверие держится.