ИИстерика
Мусор на входе - бред на выходе: почему красивые ИИ-отчёты часто врут
_ИИстерика_#1
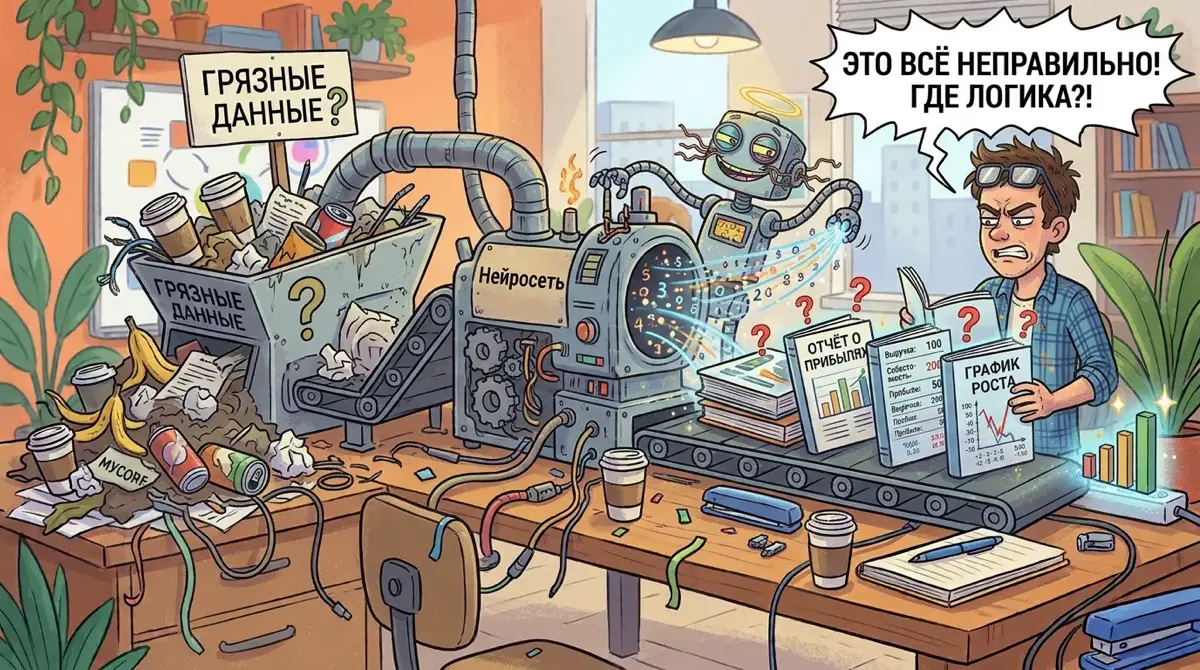
Друзья! В последнее время лента пестрит постами про то, как искусственный интеллект за пару секунд собирает финансовые модели, строит безупречные дашборды и генерирует управленческую отчетность. У всех всё так чисто и красиво. Вот выручка, вот маржа, вот графики. И все хором вещают: «Просто закиньте данные в нейросеть!» У меня возникает простой вопрос: откуда вы взяли такие аккуратные данные? Если это учебный пример – вы так и скажите! Потому что в реальной жизни таких идеальных данных не бывает. На практике данные собираются из десятков источников, половину из которых «на свой вкус и цвет» заполняют не самые продвинутые пользователи. Все ИИ – это языковые модели. Они не предназначены для расчётов, и не умеют «считать в уме»! Когда нужно сделать вычисления, нейросети сами пишут программный код (чаще всего на Python), и исполняют его в изолированной среде. Поэтому результаты расчётов критически зависят от того, сможет ли автоматически написанный программный код корректно обработать ваши таблицы. На сложной «визуальной» верстке Excel-файлов и «кривых» выгрузках из 1С – алгоритмы часто «спотыкаются», и выдают ошибки… Так что, если вы загружаете ваши данные в ИИ, то это должны быть Tidy Data — «чистые» данные, с которыми нейросети удобно работать. Tidy Data - это жестко структурированные, «плоские» таблицы, где каждая переменная находится в отдельном столбце, каждая транзакция в отдельной строке, где нет никакого мусора, объединенных ячеек, громоздких «шапок», и прочей шелухи. А что происходит в реальных компаниях? Ваши таблицы – это Tidy Data или безумные творения креативного финансиста!? Какой нафиг ИИ, когда у вас в исходных данных чёрт ногу сломит?! Какой нафиг ИИ, когда ваши данные хранятся в сотне разных таблиц разной структуры и форматов?! Какой нафиг ИИ, когда в том, какие данные достоверны, какие – нет, знает только финансовый директор?! Какой нафиг ИИ, когда «здесь играем, здесь не играем, здесь рыбу заворачивали»?! В реальной жизни данные подавляющего большинства компаний - это фарш, который «невозможно провернуть назад» и мясо из него не восстановишь. Если вы выгрузите этот бардак в нейросеть вы получите от ИИ красивый, удобный, и АБСОЛЮТНО НЕДОСТОВЕРНЫЙ ОТЧЁТ! (Garbage in — Garbage out). Это как в анекдоте: — Я печатаю со скоростью 1400 знаков в минуту! — Ничего себе! — Да... Но такая херня получается! Вот и с ИИ в финансах точно так же. Скорость невероятная, а на выходе – красивая, но абсолютно бесполезная фигня. Зато быстро. И красиво. И современно. И в тренде. И всё вот это вот!
Ключевая мысль Главная проблема большинства компаний – не «сделать отчёты», а «собрать исходные данные для отчётов». Да. Это скучно и неинтересно. Зато гораздо полезнее, чем ИИ-психоз! Вот вам примерный алгоритм: 1. Проработать и утвердить единые справочники и классификаторы, которые будут использовать все и везде . 2. Разработать и утвердить регламенты учёта - кто, когда, какие операции и в какие программы или таблицы вводит. 3. Придумать механизмы контроля – как мы будем проверять ввод данных. 4. Привести существующие данные в соответствие с утверждёнными правилами - удалить дубли в справочниках и перепровести документы в 1С, структурировать и почистить таблицы Excel, и т.д., и т.п.. Абсолютно неважно, в какой системе вы ведёте учёт - в Excel, 1С, любой другой, или нескольких одновременно. Порядок придётся наводить ВЕЗДЕ! На выходе у вас должен появится Источник Истины (Single Source of Truth) – единый массив данных, где все цифры 100% структурированы, достоверны и проверяемы. Только после этого можно загружать данные в ИИ, строить красивые дашборды, и всё вот это вот! Прежде чем лететь в космос на крыльях ИИ – разгребите бардак, и научитесь собирать «чистые» данные.
P.S. Возможно, я только что убил чью-то мечту - так что накидайте мне деструктивной критики в комментариях в MAX или в Telegram! 😊