Почему generic TTS на живом звонке убивает доверие, хотя перевод точный.
Обычные переводчики отдают текст или читают его синтетическим голосом. Собеседник слышит робота, паузы неестественные, контакт рвётся. На клиентском звонке или практике ты уже думаешь, как объяснить, что это не ты.
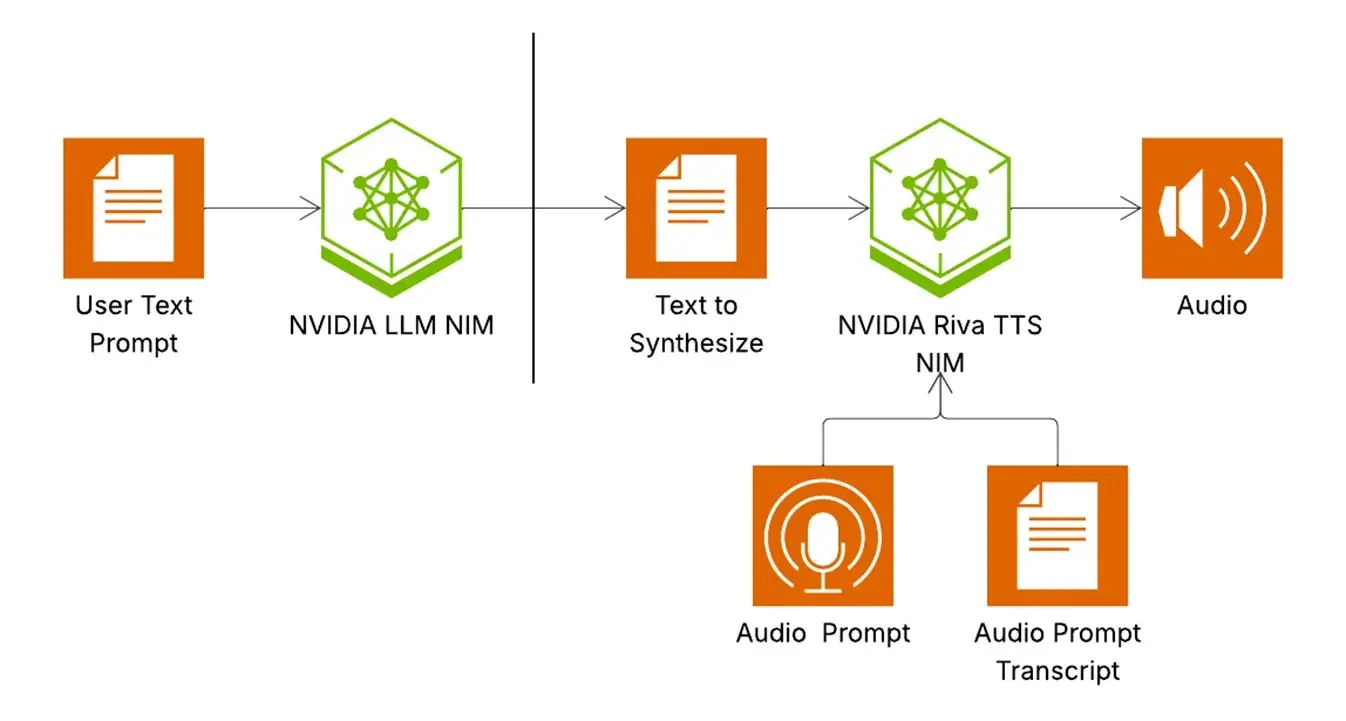
Talkaside строит локальный голосовой профиль: 10–60 секунд твоей чистой записи. Speaker encoder вытаскивает embedding (тембр, просодия, акцент). На NVIDIA GPU модель синтезирует перевод в твоём голосе и кидает обратно в звонок через виртуальный mic или routing.
Dual-stream WASAPI держит входящий чистым для STT/MT (Hy-MT2, 27 языков), исходящий — для клонирования. Всё на машине: профиль, история, транскрипт в %LOCALAPPDATA%Talkaside. Никакого облака по умолчанию, ты выбираешь провайдеров. Failover не даёт latency убить поток.
На любом разговоре — интервью, клиент, language practice — перевод звучит как ты, без робота и без слива голоса.