


Непрерывность как продукт: клиент покупает не систему…
Представьте обычный понедельник. 9:00 — команда запускает продажу 9:15 — CRM перестаёт отвечать 9:20 — менеджеры пишут в общий час 9:30 — IT сообщает: «Разбираемся» 10:00 — клиенты начинают уходить к конкурентам
А ведь ещё вчера система была полностью исправна.
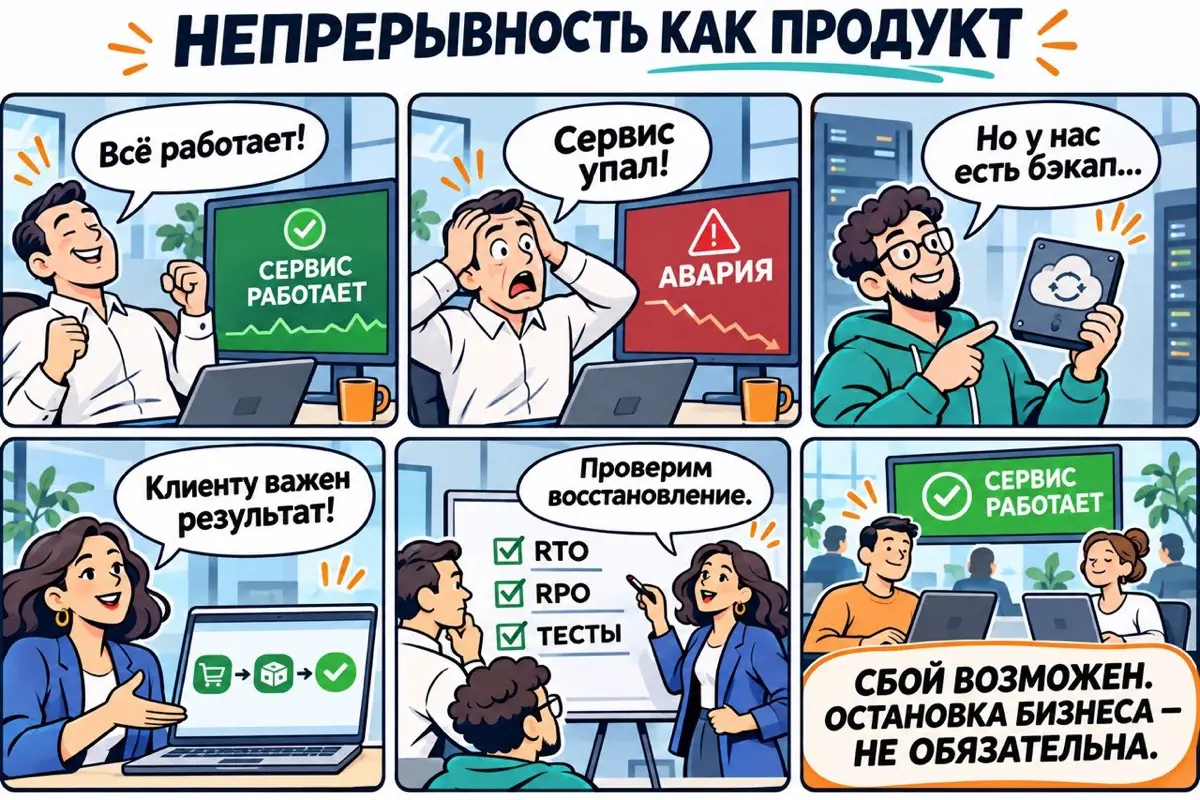
Вот здесь и возникает интересный вопрос: а что, если непрерывность работы - это не просто задача IT, а полноценный продукт?
🔹 От функции к ценности Мы привыкли считать продуктом приложение, платформу, сервис или подписку. Но бизнесу нужен не сервер, который работает 99,9% времени. Ему нужны заказы, которые не теряются, платежи, которые проходят, и сотрудники, которые могут выполнять свою работу. Клиент не покупает резервное копирование ради резервного копирования. Он покупает возможность продолжать работу даже тогда, когда что-то пошло не по плану.
Непрерывность - это способность бизнеса сохранять критически важные функции при сбоях и восстанавливать их в приемлемые сроки.
И эту способность можно проектировать, измерять, развивать и предоставлять как сервис. 🔹 Почему «у нас есть бэкапы» - недостаточно Представьте ресторан. У него есть запасной генератор. Но при отключении электричества выясняется, что генератор не подключён к холодильникам, сотрудники не знают, кто его запускает, а ответственный инженер сегодня в отпуске. Формально резерв есть. Фактически непрерывности нет. То же самое происходит в IT. Можно иметь резервные серверы, облако и подробную документацию, но потерять часы из-за одного незадокументированного действия.
Непрерывность появляется не тогда, когда у вас есть план Б, а тогда, когда план Б действительно работает.
🔹 Как превратить непрерывность в продукт У любого продукта есть потребитель, ценность, характеристики и критерии качества. У непрерывности они тоже есть. 1. Потребитель. Бизнес-подразделение, команда или клиент, для которого остановка процесса означает реальные потери. 2. Ценность. Предсказуемость работы, снижение последствий сбоев, уверенность в восстановлении критических процессов. 3. Характеристики. Допустимое время простоя, допустимая потеря данных, устойчивость к отказам, скорость обнаружения и устранения инцидентов. 4. Пользовательский опыт. Понятные статусы, своевременные уведомления, прозрачная ответственность и отработанный сценарий восстановления. 5. Постоянное развитие. Тестирование, учения, анализ инцидентов и улучшение архитектуры. В результате появляется не набор технических мер, а сервис с понятным уровнем качества.
🔹 Три показателя, которые стоит знать не только IT SLO (Service Level Objective) - целевой уровень качества сервиса. Например, доступность ключевого процесса в течение 99,95% времени за установленный период. RTO (Recovery Time Objective) - целевое время восстановления после сбоя. Например, вернуть возможность принимать платежи за 15 минут. RPO (Recovery Point Objective) - допустимая потеря данных по времени. Например, восстановить данные с потерей не более пяти минут последних изменений. Важно: эти показатели не гарантируют результат сами по себе. Их необходимо подтверждать проверками и реальными испытаниями.
🔹 Кто должен владеть продуктом непрерывности?
Здесь начинается самое интересное. Если за непрерывность отвечает только IT, она рискует превратиться в историю про серверы. Если только служба безопасности - в историю про регламенты. Если только бизнес - в набор ожиданий без технической реализации. Поэтому нужна совместная ответственность. Бизнес определяет, какие процессы критичны и сколько стоит их остановка. IT и инженерные команды создают устойчивую архитектуру. Безопасность и управление рисками помогают подготовиться к неблагоприятным сценариям. А владелец продукта непрерывности связывает всё это в управляемый сервис с приоритетами, метриками и дорожной картой.
🔹 Самая дорогая ошибка - думать, что ничего не случится Непрерывность трудно продавать внутри компании. Пока всё работает, кажется, что расходы на неё не приносят результата. Но это похоже на тормоза автомобиля. Мы ценим их не за количество применений, а возможность безопасно продолжать движение.


· 4 ч
При этом абсолютная непрерывность недостижима или экономически нецелесообразна. Поэтому задача продуктового подхода - определить, какая устойчивость действительно нужна бизнесу и сколько он готов за неё платить.
🔹 Главная мысль
Продукт - это не обязательно то, что пользователь видит на экране.
Иногда лучший продукт - тот, благодаря которому пользователь вообще не замечает проблем.
Непрерывность не означает отсутствие сбоев.
Она означает, что даже при сбое бизнес знает, что делать, кто отвечает за восстановление и когда критически важные процессы вернутся к работе.
Раньше мы строили системы, которые должны работать. Сегодня нужно строить бизнес-процессы, которые способны продолжать работу даже тогда, когда отдельные системы отказывают.
#ПродуктовыйМенеджмент #НепрерывностьБизнеса #IT #BusinessContinuity #УправлениеРисками #SRE
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён
· 3 ч
Тогда хорошая проверка непрерывности — пройти на учениях весь путь до принятого заказа. Как вы выбираете первый процесс для таких учений, если на проверку всех сценариев бюджета не хватает?
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён
· 3 ч
Я бы выбирал первый процесс не по технической сложности, а по цене его остановки для бизнеса.
Для приоритизации использовал бы три критерия:
1. Критичность - сколько бизнес теряет при остановке процесса: деньги, клиентов, репутацию, обязательства. 2. Зависимости - сколько систем, команд и внешних сервисов участвуют в процессе. Именно на стыках часто обнаруживаются слабые места. 3. Неопределённость восстановления - насколько мы уверены, что процесс действительно заработает после сбоя, а не просто восстановятся серверы.
Начал бы с одного критичного клиентского сценария и прошёл его полностью: от обращения клиента до успешно принятого и сохранённого заказа.
При ограниченном бюджете важно не количество проверенных сценариев, а максимальное снижение неопределённости за одни учения.
И здесь как раз проявляется продуктовый подход: мы инвестируем не в количество тестов, а в подтверждённую способность бизнеса продолжать работу.
Лучшие учения - те, после которых мы не просто знаем, что сломается, а понимаем, что нужно изменить. Если систем много - от MC/BC и ниже, с оценкой вероятности выхода из строя.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён