Массовый сбой в крупных банках США
Даже крупнейшие банки США не застрахованы от технических сбоев. А ваша система?
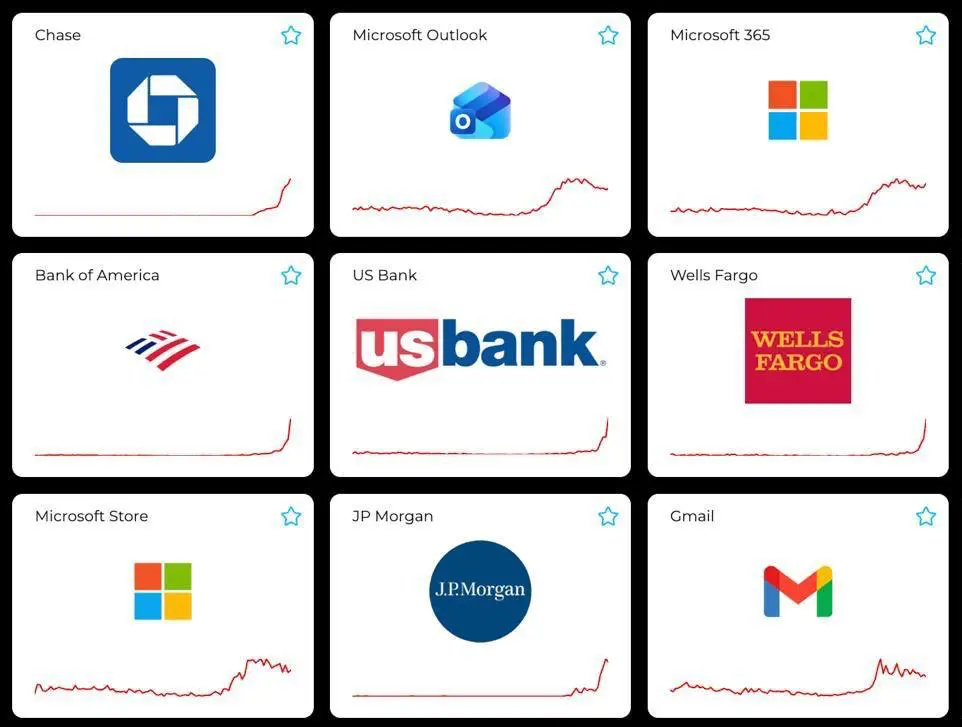
16 ноября пользователи сразу нескольких крупных американских банков столкнулись с проблемами в работе цифровых сервисов.
Среди них — JPMorgan Chase, Bank of America, Wells Fargo и U.S. Bank. Клиенты сообщали о проблемах со входом в приложения, доступом к счетам и выполнением операций.
Причём сбои затронули не только пользовательские приложения, но и отдельные банковские API-интеграции.
И это инфраструктура организаций, располагающих огромными ИТ-бюджетами, командами специалистов и серьёзными требованиями к надёжности.
Но даже такие ресурсы не гарантируют стопроцентную доступность.
Это, однако, не означает, что можно пренебрегать архитектурой, отказоустойчивостью и тестированием. Скорее наоборот.
Хорошая архитектура — не та, которая никогда не ломается. А та, которая готова к тому, что рано или поздно что-нибудь сломается.
Можно потратить миллионы на оборудование, облачные сервисы и разработку, но оставить единственную точку отказа, способную остановить всю систему.
Поэтому при проектировании важно думать не только о том, как система будет работать в штатных условиях, но и о том, что произойдёт при отказе базы данных, сетевого оборудования, внешнего API или целого дата-центра.
Есть ли резервирование? Изолируются ли сбои отдельных компонентов? Можно ли быстро восстановить работу? Сохранятся ли данные? Сможет ли бизнес продолжить работу хотя бы с ограниченной функциональностью?
И главное — проверяли ли мы всё это на практике или просто надеемся, что ничего не случится? Инциденты такого масштаба напоминают: абсолютной надёжности не существует. Но существует инженерная ответственность за последствия отказов. Системы будут ломаться. Вопрос лишь в том, насколько мы к этому готовы.