Почему перевод на живом звонке звучит чужим роботом и убивает доверие, даже когда смысл передан точно.
Обычный TTS берёт текст после STT+MT и кормит в фиксированный голос. Собеседник слышит синтетику, тон пропадает. Большинство инструментов всё ещё даёт «нейтральный» голос.
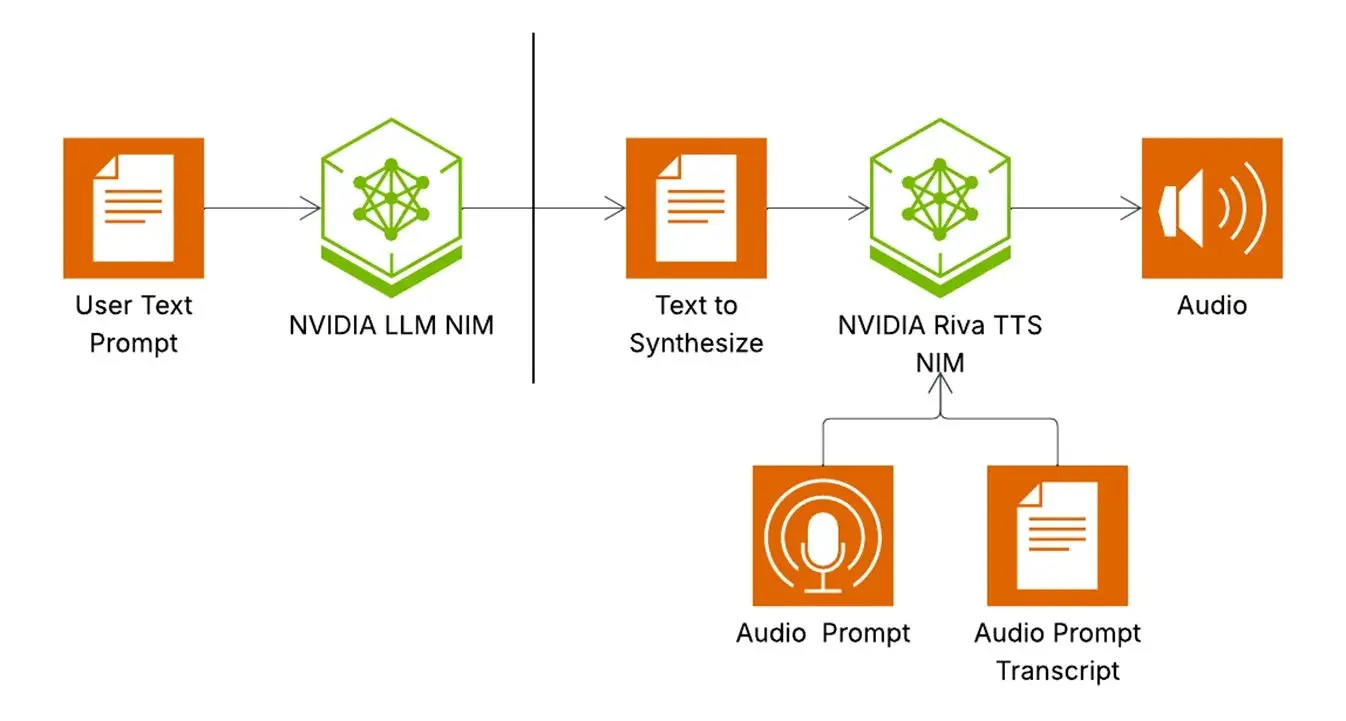
Voice cloning: референс 3–10 с → speaker encoder → embedding. Он кондиционирует акустическую модель. Mel или codec-токены → vocoder (HiFi-GAN, F5-TTS, XTTS). На выходе твоя тембр + новая просодия. First audio 150–400 мс на GPU.
Talkaside берёт dual-stream WASAPI (mic отдельно от loopback), STT (Whisper/Parakeet локально или облако с failover), перевод Hy-MT2 (27 языков) и озвучивает твоим клоном. Practice mode разбирает грамматику на исходном, ты слышишь себя на целевом. Companion даёт формулировки в скрытой панели.
Аудио и история локально. Ты выбираешь провайдера. После звонка транскрипт с таймстемпами и AI-сводка на диске.