




Что я забрал с референс-визита по AI-разработке
Сегодня был на референс-визите в одном известном банке. Слушал, как они подходят к AI adoption в разработке.
Не буду пересказывать всё. Забрал для себя четыре практических мысли.
1. Начинать стоит не с модели, а со спецификации Один из подходов — SDD, Spec-Driven Development.
Идея простая: Business → Story → Specification → Code
То есть прежде чем отдавать задачу агенту, мы должны нормально описать: — что должно получиться; — какие есть ограничения; — какие контракты нельзя ломать; — по каким критериям принимаем результат.
Под это уже есть отдельные инструменты и подходы: например OpenSpec и BMAD.
Для меня здесь главный вывод: чем больше кода пишет AI, тем важнее качество постановки задачи.
2. Agent Harness — это уже отдельный инженерный слой LLM сама по себе код в production не доставит.
Вокруг неё появляется harness: — контекст; — доступ к репозиторию; — tools; — команды сборки; — тесты; — правила работы с кодом; — циклы исправления ошибок.
То есть агенту фактически создают среду, в которой он может работать как инженер. И это уже надо проектировать.
3. Harness тоже надо тестировать Очень хороший тезис, который услышал сегодня:
Harness тоже требует evals. Допустим, поменяли system prompt или добавили новый tool. Кажется, что агент стал умнее. Но это надо доказать.
Берём набор реальных задач и сравниваем: — сколько задач решил; — сколько потребовалось вмешательств человека; — сколько ошибок допустил; — сколько стоило выполнение; — сколько времени заняло.
То есть постепенно появляется обычный инженерный цикл: изменение → benchmark → eval → решение о внедрении.
4. AI adoption тоже нужно мерить Мне понравилась идея считать не просто количество пользователей AI, а реальный результат.
Например: output / трудоёмкость То есть сколько полезного результата команда производит на единицу инженерных затрат.
И рядом обязательно смотреть: lead time, quality, CFR, cost. Потому что если команда стала писать на 30% больше кода, но количество инцидентов выросло в два раза — это не adoption.
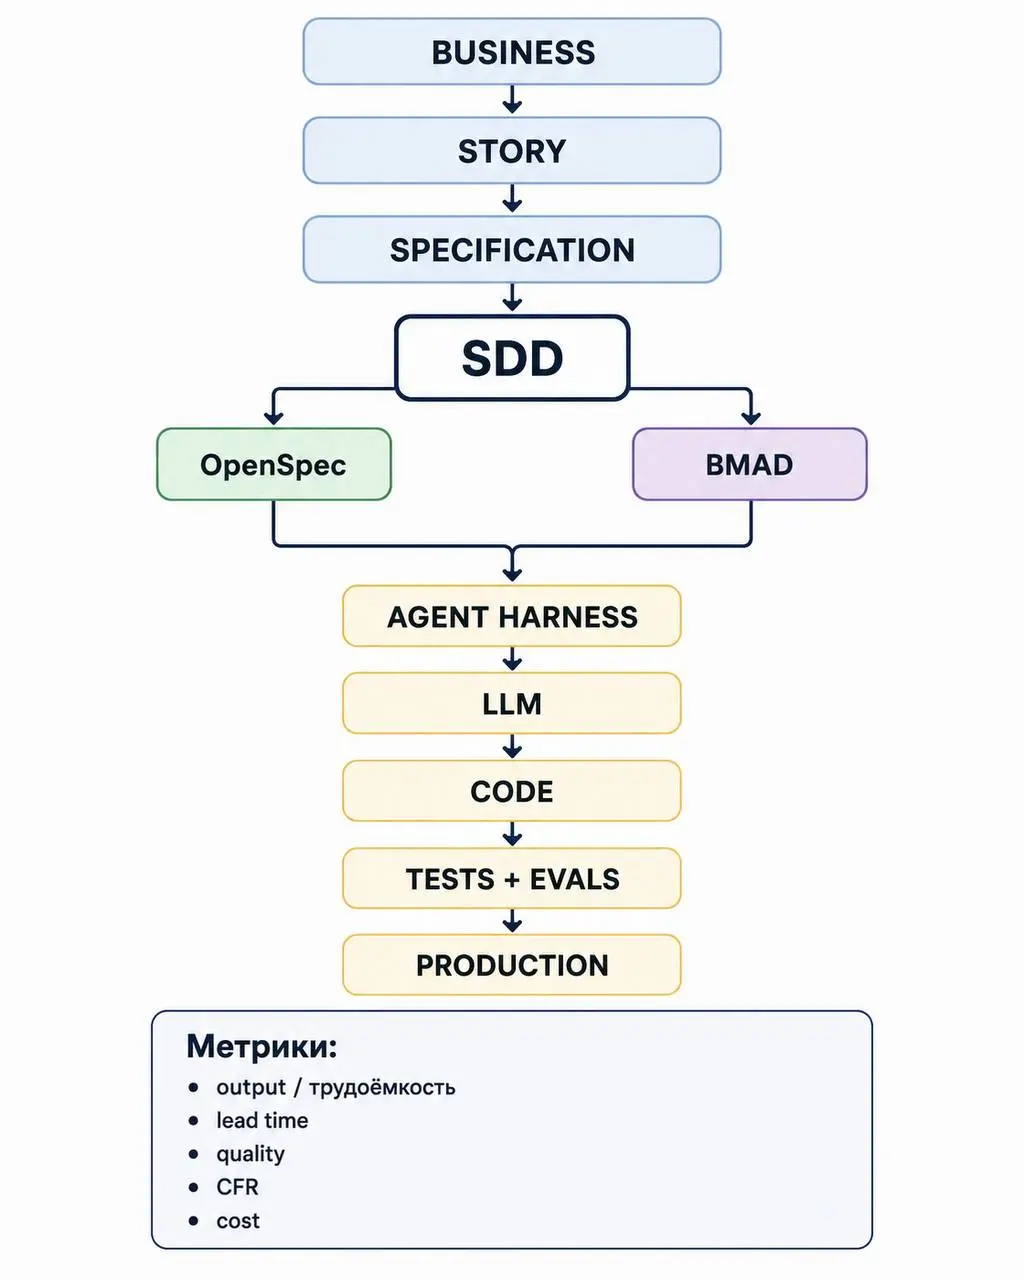
В итоге для себя собрал довольно простую модель:
Business → Story → Specification → SDD → Agent Harness → LLM → Code → Tests + Evals → Production А снизу — метрики.
Вот это уже похоже не на эксперимент с AI, а на нормальный инженерный процесс.
И, пожалуй, именно с этого я бы сегодня начинал строить AI SDLC внутри большой компании.

















· 10.09
Спеки на больших объемах сами по себе становятся проблемой Это для мелких проектов и совсем тупых сеток. Уже есть более проверенные и надежные решения.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён